Wie Wiki-Systeme mit KI umgehen und warum das für regulierte Organisationen wichtig ist
KI ist im Wiki-Markt angekommen. Jede grosse Plattform bietet inzwischen KI-gestütztes Schreiben, semantische Suche oder einen Chat mit der Wissensbasis. Für Teams ohne regulatorische Vorgaben ist die Wahl vor allem eine Frage von Funktionen und Preis. Für Organisationen in regulierten Branchen, in der öffentlichen Verwaltung oder überall dort, wo sensible Daten im Spiel sind, kommt eine folgenreichere Frage hinzu: Wer bestimmt, was die KI mit deinem Wissen macht, und nach welchem Recht?
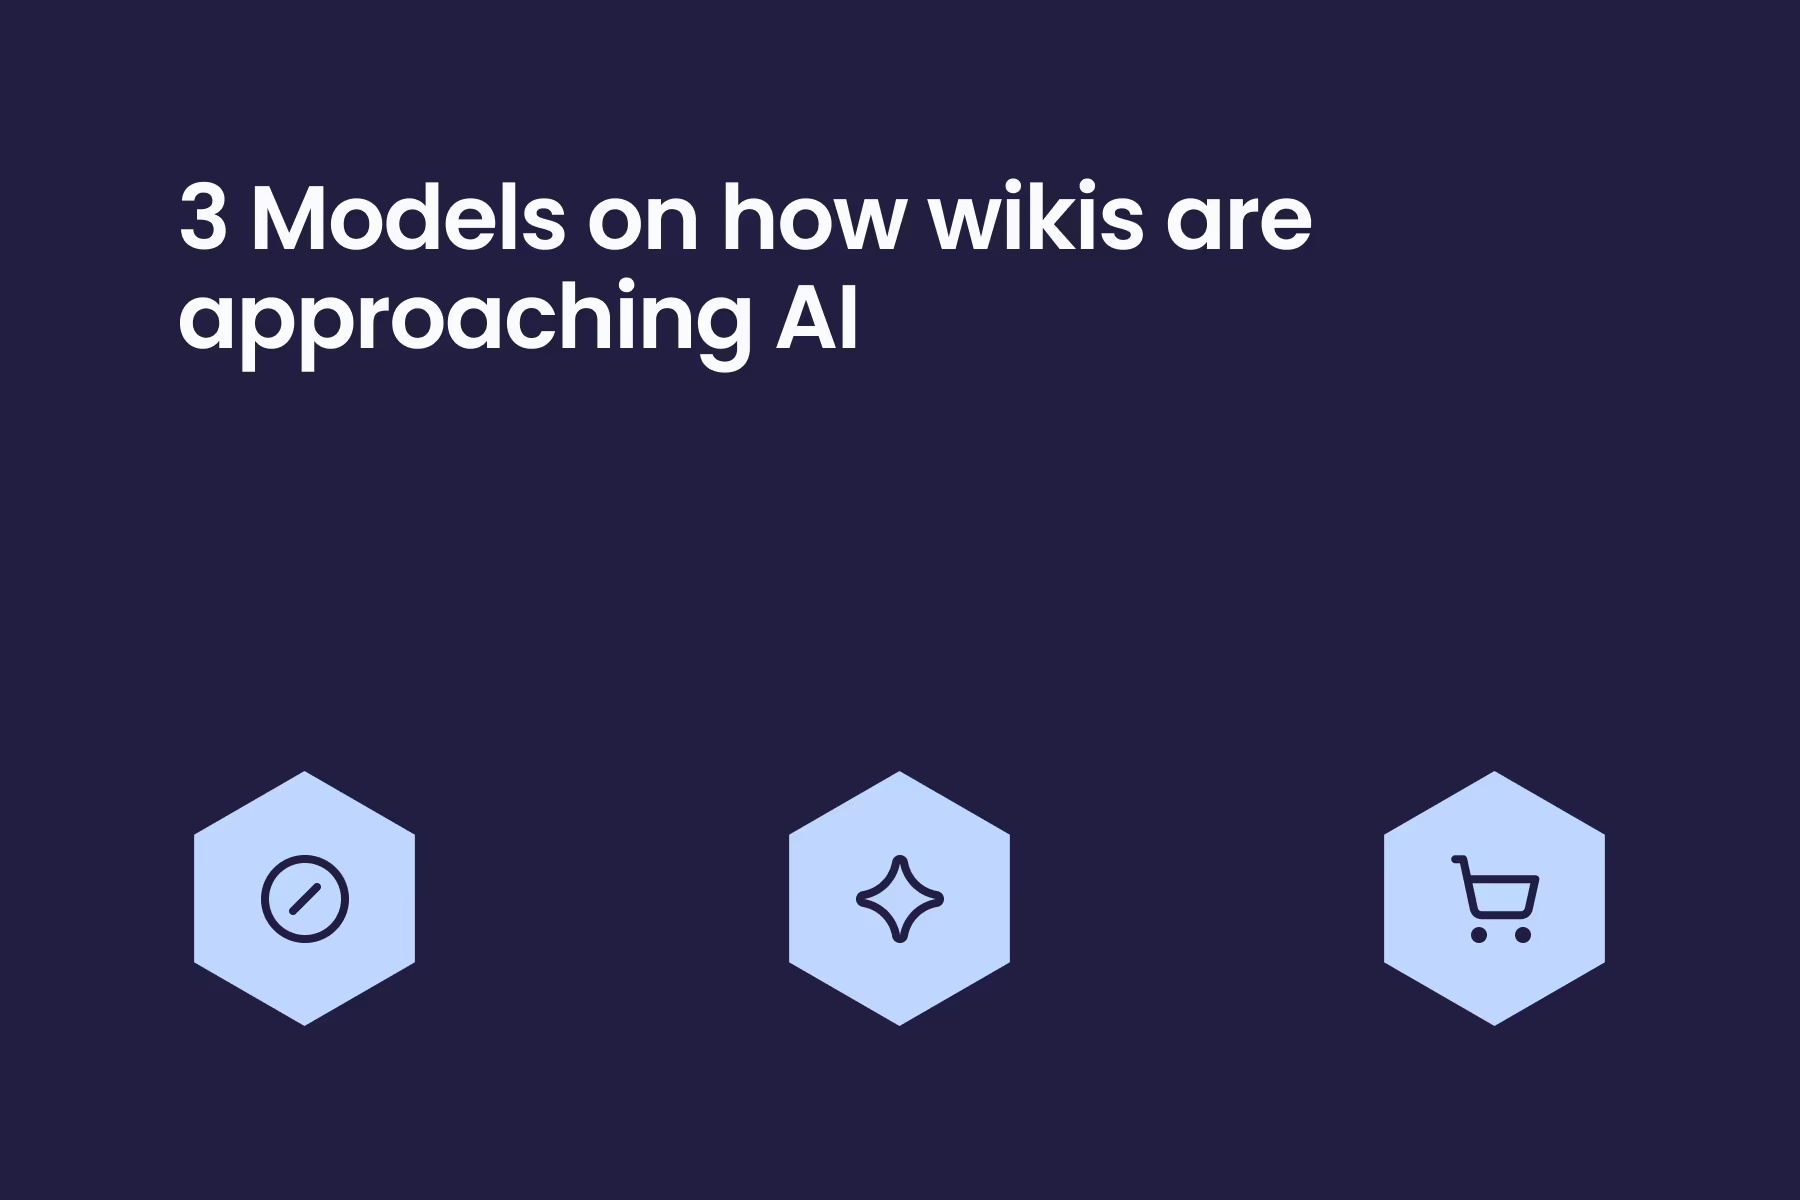
Die heute verfügbaren Wiki-Plattformen gehen das Thema KI nicht alle gleich an. Die zugrunde liegenden Architekturmodelle und ihre Folgen für die Data Governance zu verstehen, bringt mehr als ein Vergleich von Funktionslisten. Funktionen ändern sich laufend, die Architektur nur selten.
Die entscheidenden Fragen für regulierte Organisationen
Sobald eine Wiki-Plattform KI-Funktionen erhält, stellen sich sofort mehrere Fragen:
- Welches LLM verarbeitet deine Inhalte? Ein vom Anbieter gewähltes Modell, auf das du keinen Einfluss hast, oder kannst du selbst wählen?
- Wo findet die Verarbeitung statt? Infrastruktur in den USA bedeutet US-Recht, ganz egal, wo die Daten gespeichert sind.
- Werden deine Inhalte genutzt, um KI für andere zu trainieren? Es ist ein Unterschied, ob ein Anbieter deine Daten verarbeitet, um dir einen Dienst zu leisten, oder ob er damit sein Produkt für alle Kund:innen verbessert.
- Kannst du widersprechen? Lassen sich bestimmte Inhalte, etwa sensible Dokumente oder Compliance-Unterlagen, vollständig von der LLM-Verarbeitung ausnehmen?
- Ist die KI produktionsreif? Auf eine Beta-Funktion kannst du dich bei geschäftskritischen Anwendungen nicht verlassen.
Die Antworten hängen fast vollständig davon ab, welches der drei Architekturmodelle eine Plattform verfolgt.
Modell 1: Keine native KI
Manche Wiki-Plattformen bieten überhaupt keine KI-Funktionen. Die Suche basiert auf Stichworten. Es gibt keine Textgenerierung, keine semantische Suche und keine LLM-Integration. Wer KI braucht, muss sie selbst entwickeln: eine separate Vektordatenbank, eine externe LLM-API sowie eine eigene Schicht für Abfrage und Textgenerierung, die gebaut und gewartet werden muss.
Aus Sicht der Souveränität ist dieses Modell von Haus aus sauber. Die Plattform bringt keine KI-Verarbeitung durch Dritte, keine externen Datenflüsse und kein vom Anbieter vorgegebenes LLM mit. Was die Organisation mit KI macht, liegt allein in ihrer Hand und in ihrer Verantwortung.
Die Kehrseite ist der praktische Nachteil. Eine produktionsreife KI-Schicht auf einer Plattform aufzubauen, die nicht dafür gemacht ist, ist ein grosses Projekt, das die meisten Organisationen auf unbestimmte Zeit verschieben. Und «heute keine KI» heisst zunehmend «auch morgen kein Weg zur KI», jedenfalls nicht ohne Plattformwechsel. Mehrere schlanke Open-Source-Wikis wie BookStack oder DokuWiki gehören in diese Kategorie.
Modell 2: Vom Anbieter verwaltete KI
Die meisten grossen kommerziellen Wiki-Plattformen setzen auf ein Modell, bei dem die KI fest eingebaut ist. Sie läuft über ein oder mehrere LLMs, die der Anbieter ausgewählt hat, und ist Teil des Abonnements. Du bekommst die KI-Funktionen, der Anbieter kontrolliert den KI-Stack.
Die Funktionen in diesem Modell sind oft beeindruckend: Textgenerierung im Editor, semantische Suche, Chat mit der Wissensbasis, autonome Agenten. Die Folgen für die Souveränität sind jedoch struktureller Natur. Die LLM-Anbieter sind meist grosse US-amerikanische KI-Unternehmen. Die Verarbeitung läuft auf Infrastruktur ausserhalb deiner Kontrolle. Du kannst kein anderes Modell einsetzen, die Verarbeitung nicht in eine von dir geprüfte Rechtsordnung verlegen und bestimmte Inhalte nicht von der KI ausnehmen, ohne ganz auf die Funktionen zu verzichten.
Ein weiteres Risiko: Der Anbieter kann die Bedingungen für die KI-Nutzung einseitig ändern. Mehrere grosse Plattformen nutzen inzwischen Kundeninhalte in anonymisierter Form, um ihre KI für alle Nutzer:innen zu verbessern. Anonymisierung schützt aber nicht den Inhalt strategischer Dokumentation, von Compliance-Unterlagen oder sensiblen Geschäftsinhalten davor, als Trainingssignal verwendet zu werden. Widersprechen kannst du meist nur in den teuersten Plänen, standardmässig ist die Nutzung aktiviert.
Beispiel: Geänderte Trainingsbedingungen im Jahr 2026
Im Mai 2026 kündigte ein grosser Anbieter von Enterprise-Wikis eine Änderung seiner Bedingungen per August 2026 an: Metadaten und In-App-Inhalte der Kund:innen, darunter Wiki-Seiten, Projektbeschreibungen und Chatverläufe, werden genutzt, um die KI-Funktionen für alle Kund:innen der Plattform zu verbessern. Widersprechen können nur Kund:innen im Enterprise-Plan und bestimmte Compliance-qualifizierte Konten. Kund:innen im Free- und Standard-Plan haben keine Möglichkeit, der Nutzung ihrer Metadaten zu widersprechen.
Das ist kein Einzelfall. Es folgt der wirtschaftlichen Logik vom Anbieter verwalteter KI: Der Anbieter trägt die Infrastrukturkosten für das LLM und holt sie über eine Kombination aus Preisen und Daten wieder herein. Kund:innen, die keine Enterprise-Konditionen aushandeln können, akzeptieren dabei Bedingungen, die sie womöglich nie genau geprüft haben.
In diese Kategorie fallen die führenden kommerziellen Wiki- und Wissensplattformen wie Confluence, Notion, Microsoft Loop und die meisten anderen SaaS-Wissensplattformen mit Hauptsitz in den USA. Die konkreten Bedingungen unterscheiden sich. Die strukturelle Ausgangslage ist aber überall dieselbe: Der Anbieter kontrolliert den KI-Stack, und du kannst nichts austauschen.
Modell 3: Bring your own LLM (BYOLLM)
Ein drittes Modell trennt die KI-Funktionen von der KI-Infrastruktur. Die Plattform stellt die Funktionen bereit, also semantische Suche, Textgenerierung und Chat mit der Wissensbasis, und verbindet sie mit dem LLM-Endpunkt, den die Organisation selbst bereitstellt. Du wählst das Modell: einen kommerziellen Anbieter, den du geprüft und mit dem du direkt einen Vertrag hast, ein Modell in deiner eigenen Infrastruktur oder ein On-Premises-Modell ganz ohne externe Verbindung.
Damit erhältst du echte Kontrolle über die Souveränitätsfragen. Wo die KI-Verarbeitung rechtlich angesiedelt ist, bestimmt das LLM, das du wählst, und nicht der Plattformanbieter. Ob mit deinen Daten trainiert wird, regelt dein eigener Vertrag mit dem LLM-Anbieter und nicht die Standardbedingungen der Plattform. Sensible Bereiche der Wissensbasis lassen sich ganz von der KI-Verarbeitung ausnehmen, indem du sie schlicht nicht mit dem LLM-Endpunkt verbindest.
Diese Architektur ist das natürliche Zuhause für souveräne europäische Wiki-Plattformen, also solche, die ausserhalb der US-Rechtsordnung entwickelt und betrieben werden und Datensouveränität als Designprinzip verstehen statt als nachträgliches Compliance-Extra. Mehrere Plattformen in dieser Kategorie bauen gerade BYOLLM-Funktionen auf. Wie ausgereift diese Umsetzungen sind, ist sehr unterschiedlich.
Phonemos: BYOLLM im produktiven Einsatz
Phonemos setzt das BYOLLM-Modell mit produktionsreifen Funktionen um. Drei KI-Funktionen sind live:
- KI-gestützte semantische Suche: findet Inhalte nach ihrer Bedeutung, über Wiki-Seiten, Word- und PDF-Dateien sowie per OCR erkannten Text in Bildern. Standardmässig kommt das Embedding-Modell von Mistral AI zum Einsatz, jeder OpenAI-kompatible Endpunkt kann es ersetzen.
- MCP-Server: stellt die Phonemos-Wissensbasis als fundierten Kontext für jede KI-Plattform und jeden Agenten bereit, die das Model Context Protocol unterstützen, ohne dass die Daten Phonemos verlassen.
- Bring your own LLM: verbinde einen beliebigen OpenAI-kompatiblen Endpunkt, sei es ein kommerzieller Anbieter, ein Modell in deiner eigenen Cloud oder ein vollständig lokal betriebenes Modell. Dank Opt-in pro Bereich bleiben sensible Bereiche komplett von der LLM-Verarbeitung ausgeschlossen.
Phonemos wird in Bern entwickelt und betrieben. An der Plattform und ihrer Standardinfrastruktur sind keine US-Unternehmen beteiligt. Der CLOUD Act ist nicht anwendbar. Kundeninhalte werden nie genutzt, um die KI von Phonemos für andere Kund:innen zu trainieren oder zu verbessern. Die KI-Verarbeitung findet im LLM statt, das die Organisation wählt, zu den Bedingungen, die sie mit ihrem Anbieter vereinbart hat.
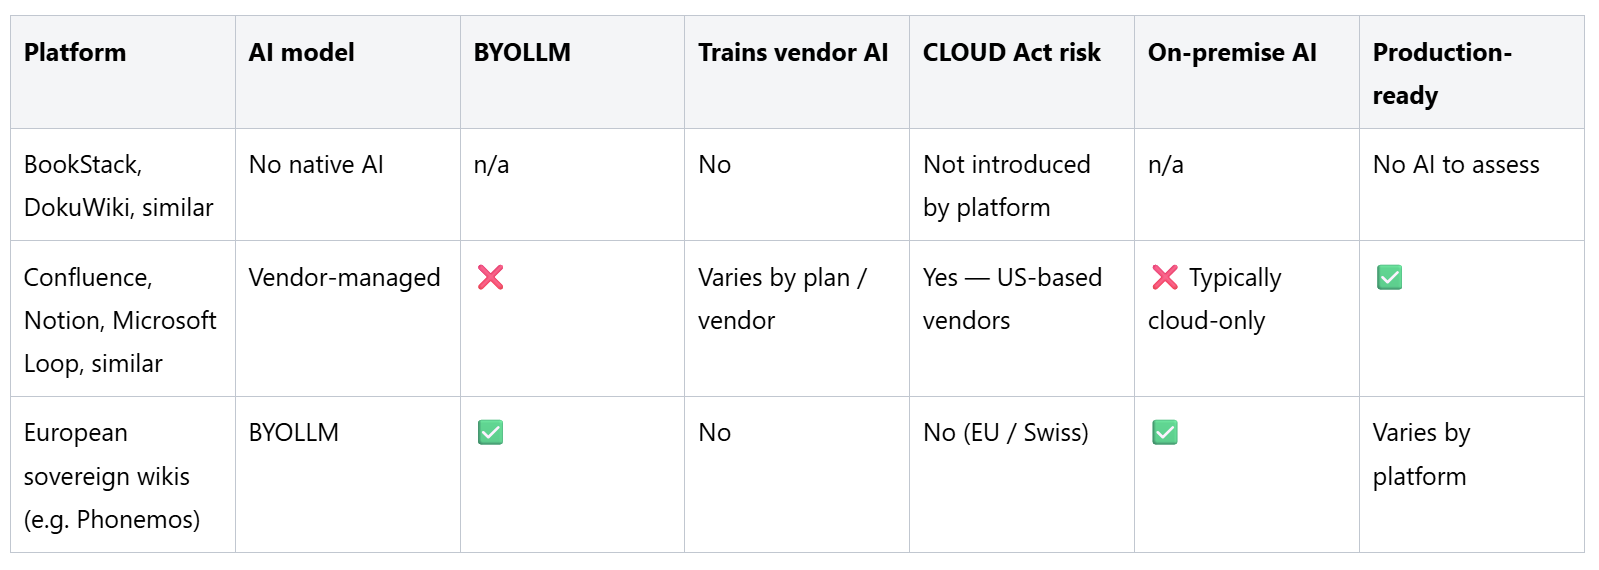
Vergleich im Überblick
Was das für regulierte Organisationen bedeutet
Der Wiki-Markt deckt bei der KI-Governance inzwischen das ganze Spektrum ab: keine KI-Funktionen, vom Anbieter verwaltete KI mit festen Anbietern und US-Recht sowie BYOLLM-Plattformen, die der Organisation echte Kontrolle geben. Wo eine Plattform in diesem Spektrum steht, wird bei der Beschaffung zu einem Kriterium, das ebenso viel Gewicht hat wie Preis oder Funktionsumfang.
Plattformen ohne native KI umgehen die Souveränitätsfrage heute. Der Preis dafür ist eine immer grössere Funktionslücke ohne klaren Weg, sie zu schliessen, ausser mit erheblichem Entwicklungsaufwand oder einem Plattformwechsel.
Plattformen mit vom Anbieter verwalteter KI bieten leistungsfähige, produktionsreife Funktionen. Der Kompromiss ist struktureller Natur: Die Organisation akzeptiert die vom Anbieter gewählten LLMs, seine Rechtsordnung und zunehmend auch sein Recht, Inhalte als Trainingsdaten zu verwenden. Für Organisationen mit strengen Anforderungen an die Data Governance sind das keine Konfigurationsdetails, sondern harte Beschaffungskriterien.
BYOLLM-Plattformen lösen die Governance-Frage auf Ebene der Architektur. Unter den souveränen europäischen Wiki-Plattformen hat sich diese Architektur als die richtige Richtung etabliert. Die Frage bei jeder einzelnen Plattform ist, wie weit die Umsetzung ist. Wer jetzt evaluiert, sollte die Produktionsreife genauso stark gewichten wie die Absicht hinter der Architektur.
Der übergeordnete Trend ist klar: KI wird zu einer Kernschicht von Wissensplattformen, und Anbieter beginnen, entsprechende Rechte an den Daten einzufordern, die durch sie fliessen. Organisationen, die ihre Haltung zur KI-Governance noch nicht festgelegt haben, also welche LLMs zugelassen sind, unter welchen Bedingungen und mit welchen Daten, werden diese Fragen von ihrem Plattformanbieter gestellt bekommen, ob sie bereit sind oder nicht.